
简易爬虫
寒假闲着也是闲着 为了提高一下自己薄弱的代码能力 于是写了这个简易工具
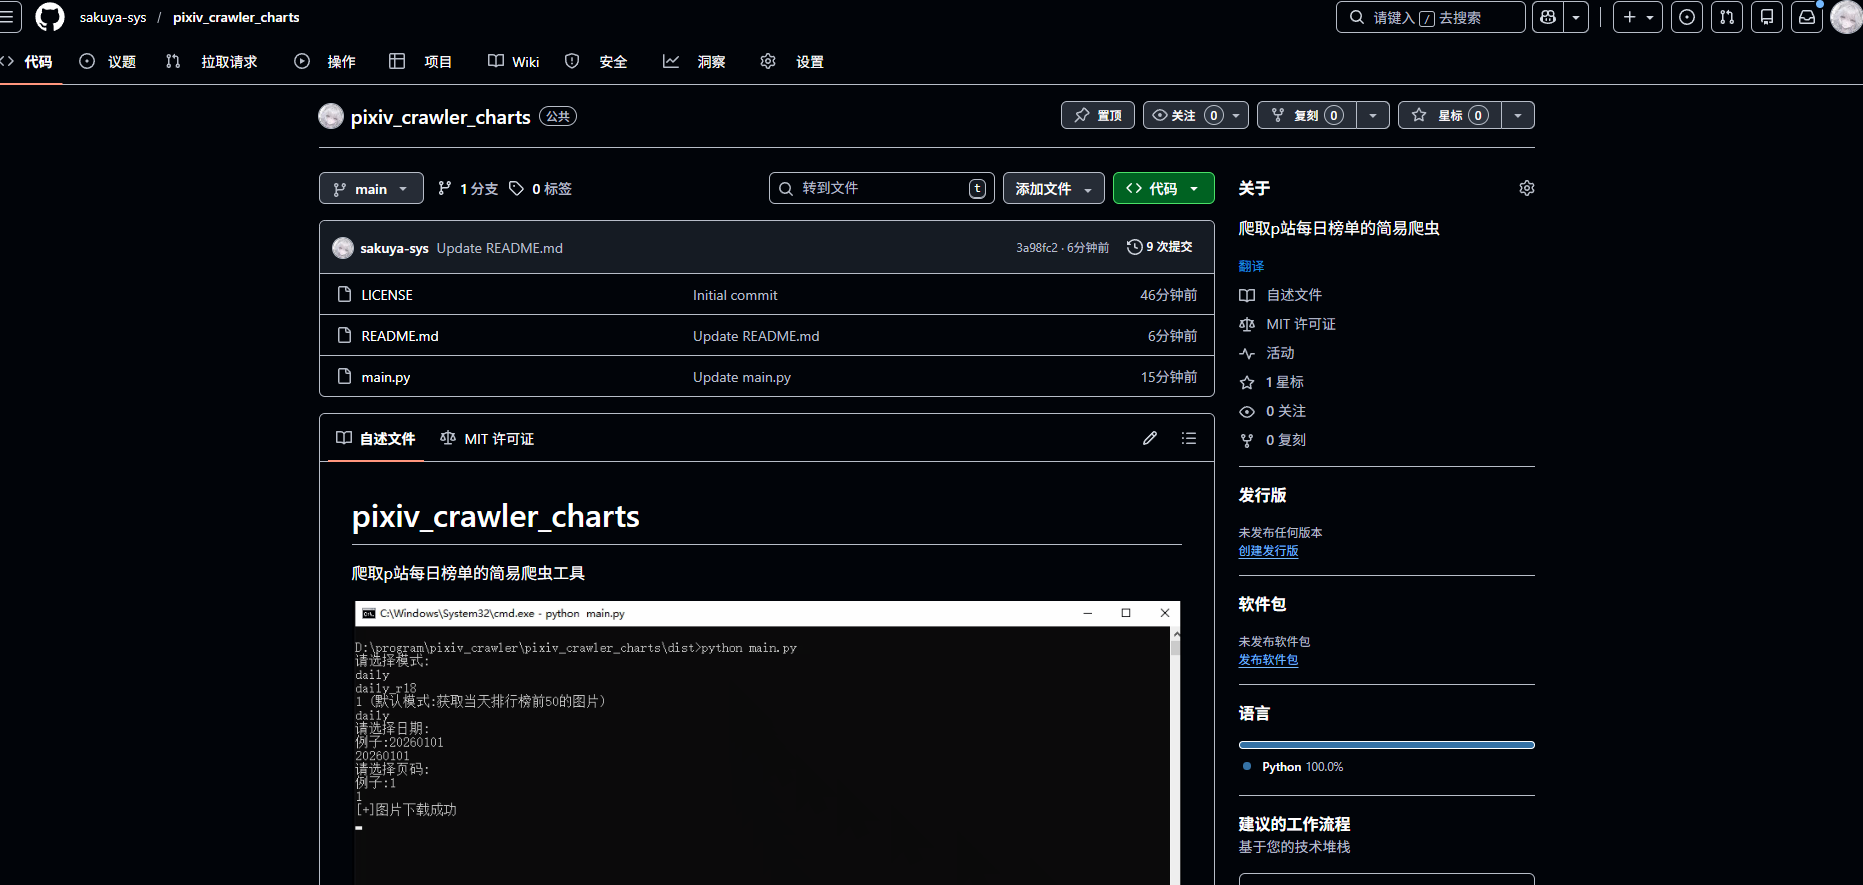
也没有使用什么爬虫框架
就自己根据p站网页结构写了一个简单的工具
由于p站有接口 所以就比较好实现这个爬虫的功能
详细使用在github上
重构代码
之前写的代码有很多不足之处 所以重构了一下 这次使用了asyncio的异步库 不再使用concurrent库实现多线程并发
使用python中的asyncio异步库使得所有函数都得写成协程函数的类型 比较麻烦
主要逻辑
由于p站是前后端分离的 所以我们只需找到p站的api即可获取想要的数据
我的爬虫逻辑为:
通过指定模式首先找到作品id -> 然后通过作品id获取到具体的详细信息 并创建一个作品类 -> 搜集好需要下载的作品并开始下载并保存到本地(p站的作品可能是单图 作品集 动图 该爬虫不下载动图 只会判断是否为单图 如果是单图就正常下载 如果是作品集则使用作品集下载函数下载)
代码结构:
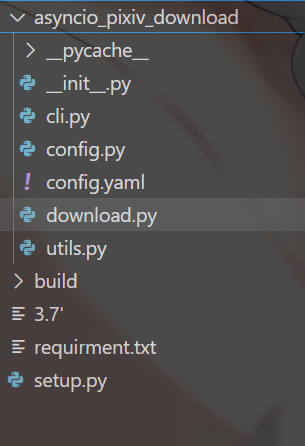
asyncio_pixiv_download文件中包括了所有的模块
配置信息包含在config.yaml中
在download模块里面写了所有下载器的类和作品类
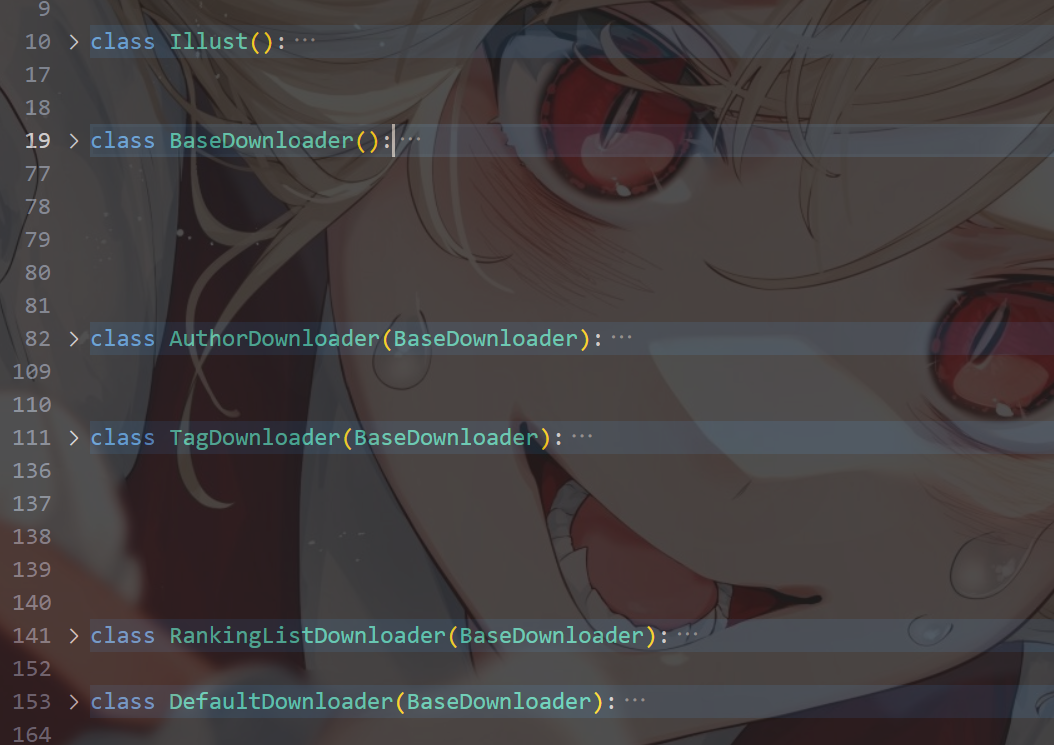
下载器类都继承基础下载器类
主要继承了以下方法
1 | getillustdata() #获取作品详细数据 |
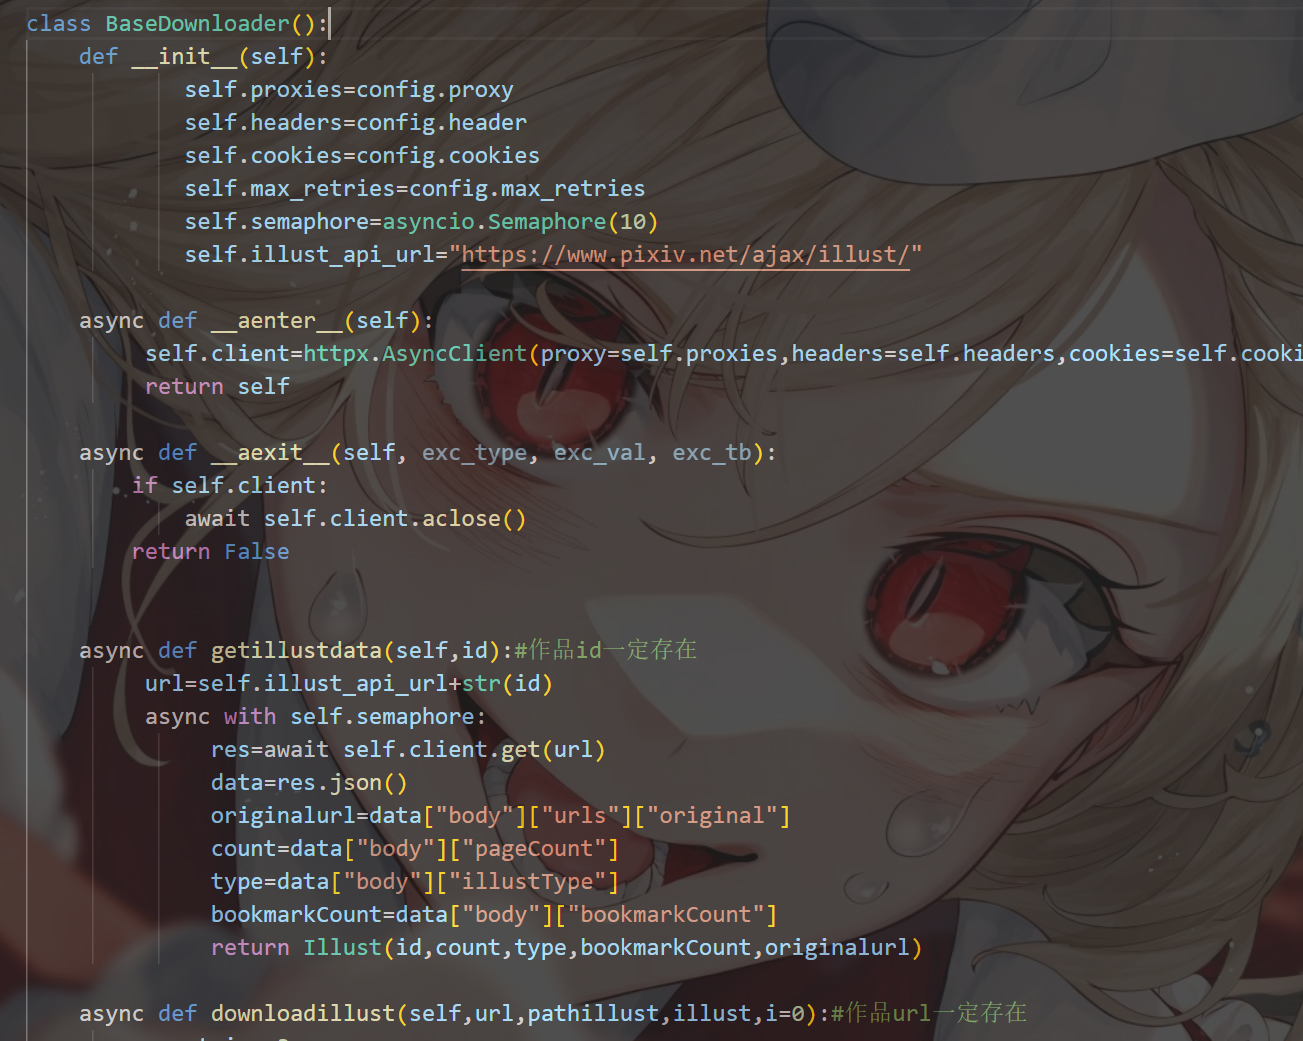
模式下载器类都各自有自己获取作品id的方法
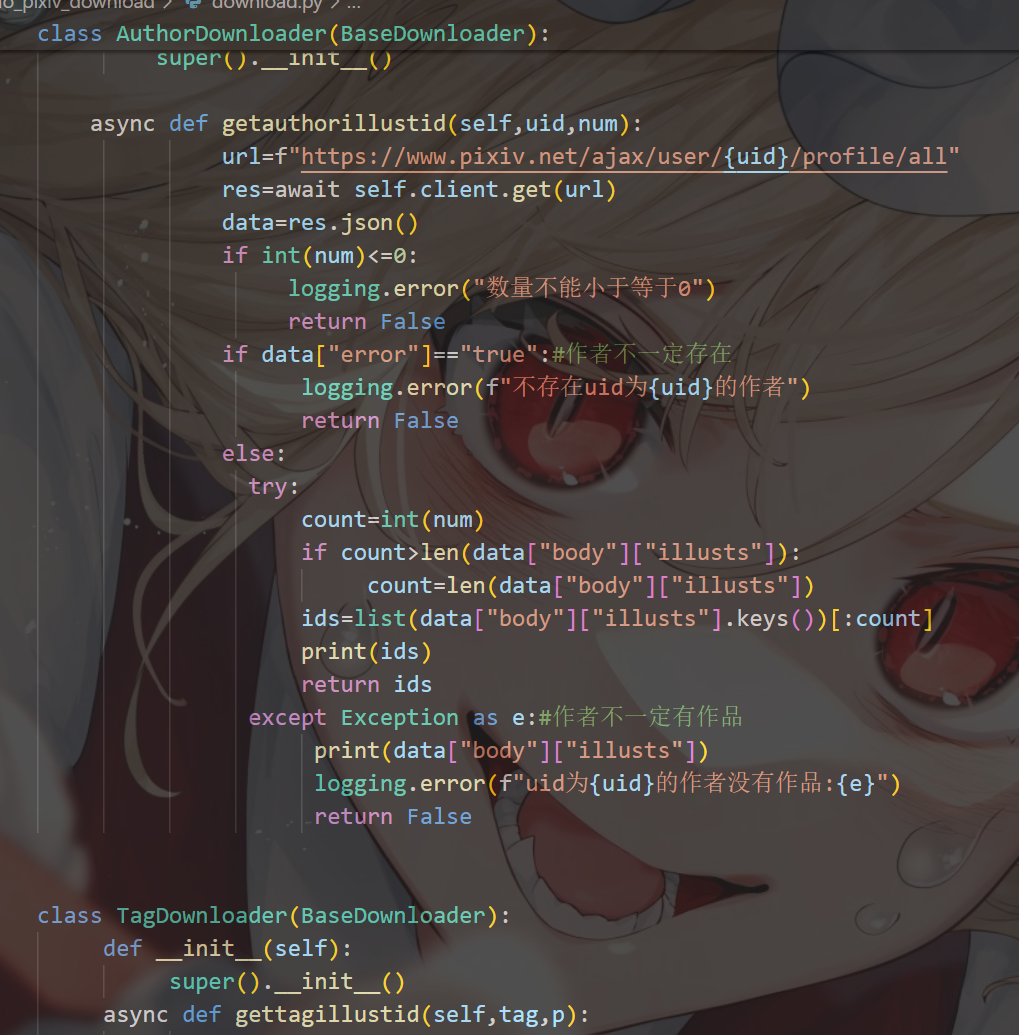
cli.py作为主逻辑写了所有下载模式的所有协程函数
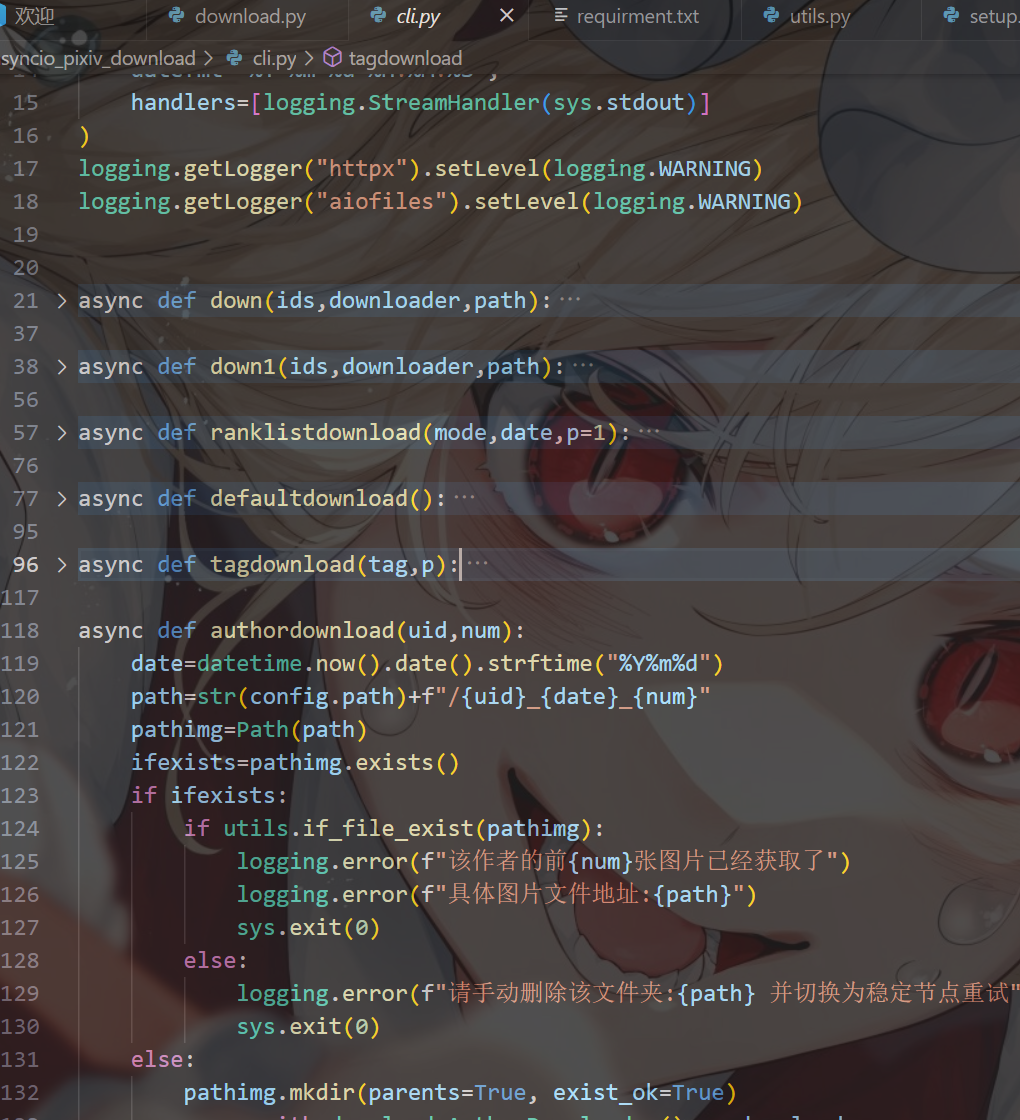
优化点
相比之前使用concurrent库的那个版本来说
修改了访问url方法 之前的每次访问都要进行三次握手建立连接 导致连接开销比较大
现在是在类中创建一个client属性使用httpx.AsyncClient()创建一个AsyncClient之后的访问直接使用client.get就可以了 不需要多次建立连接 连接得到复用
还有其他一些比较细节的地方也进行了优化
总结
第一次写这样的工具没什么经验 可能在一些地方处理的不太好
希望之后可以多写一些有趣的工具吧

说些什么吧!